Poker RL · PPO, DQN & MCTS
Entraîner, comparer et comprendre des agents de poker. Un environnement Texas Hold’em qui réunit PPO, DQN et recherche arborescente Monte Carlo.
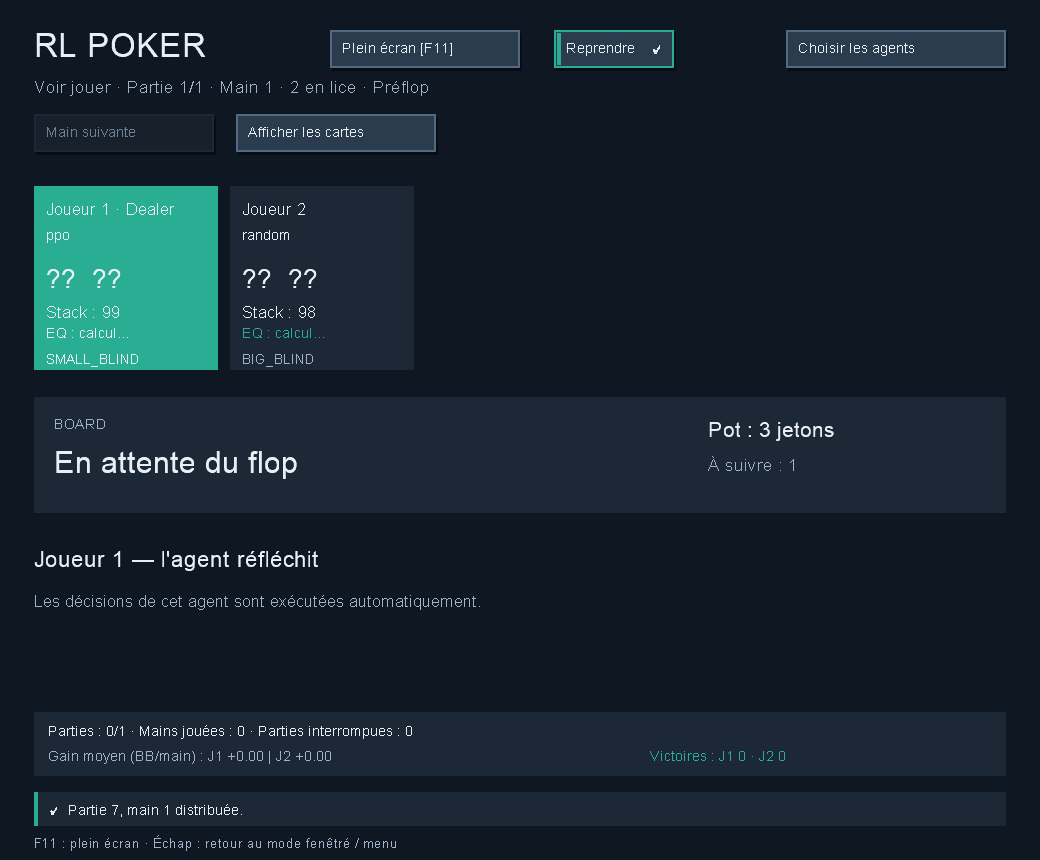
Texas Hold’em · Environnement multi-agents
Jouer pour apprendre.Mesurer pour comprendre.
Au poker, une bonne décision ne garantit pas une main gagnante. Ce projet explore cette différence : apprendre une stratégie dans un jeu à information imparfaite, puis observer ce qu’elle fait réellement.
- joueurs à la table
- 2–5
- actions discrètes
- 8
- approches comparées
- 3
Décider sans tout savoir.
Les cartes adverses restent cachées, les mises changent au fil de la main et le hasard brouille le résultat d’une décision isolée. Le Texas Hold’em offre un terrain concret pour étudier l’exploration, la prise de risque et l’apprentissage d’une politique.
Le projet relie trois dimensions : un moteur qui applique les règles, des agents qui choisissent leurs actions et des outils qui permettent de comparer leurs comportements. L’objectif est de rendre les expériences observables et reproductibles, au-delà du seul taux de mains gagnées.
De l’observation à l’action.
Une interface commune permet de changer d’agent sans modifier le moteur du jeu. À chaque décision, l’agent reçoit uniquement les informations accessibles à son siège et un masque des coups autorisés.
Observer
Cartes privées, board, position, stacks, mises et montant à suivre.
Décider
L’agent choisit parmi les huit actions, en respectant le masque légal.
Jouer
Le moteur applique l’action, fait avancer la main et calcule les gains.
Apprendre
En entraînement, les transitions alimentent les mises à jour du modèle.
Se coucher, checker, suivre, relancer à 3 BB, à un demi-pot, au pot, à deux pots ou faire tapis : l’espace d’action reste discret. Les caractéristiques poker enrichissent les observations avec les rangs, les combinaisons connues et le coût du call. Elles n’utilisent aucune carte adverse cachée. L’equity Monte Carlo affichée dans l’interface n’alimente pas la politique PPO.
Trois façons de choisir un coup.
Les agents partagent le même environnement, mais leur mécanisme de décision diffère. Des joueurs aléatoires, des heuristiques et un mode humain complètent les comparaisons.
Apprendre une politique
MaskablePPO de Stable-Baselines3 Contrib entraîne un réseau acteur-critique PyTorch. Le modèle actuel utilise un MLP sans mémoire. Les actions illégales sont masquées, et la politique peut être échantillonnée ou jouée en mode déterministe.
Estimer la valeur des actions
Un réseau prédit une valeur Q pour chaque action. Une mémoire de transitions permet de rejouer des expériences pendant l’apprentissage. L’exploration évolue avec une stratégie epsilon-greedy.
Explorer les futurs possibles
Une recherche en ensembles d’information échantillonne les cartes cachées compatibles avec la situation. Des simulations et une sélection PUCT guident l’exploration, avec une politique de rollout fondée sur la force de la main et les cotes du pot.
Séparer apprendre, choisir et tester.
Une courbe d’entraînement décrit un agent qui évolue. Pour juger un modèle, il faut aussi le faire jouer sans mise à jour, sur des situations réservées à l’évaluation.
Entraîner
Mains indépendantes, récompense terminale normalisée par le stack initial pour les nouveaux PPO, adversaires variés et snapshots figés. Les campagnes peuvent répartir les stacks entre 20, 50 et 100 BB.
Sélectionner
Comparer les checkpoints et les modes de décision sur un jeu distinct. Les campagnes peuvent tester plusieurs initialisations et taux d’apprentissage avant de retenir un réglage.
Tester
Évaluer des copies figées avec de nouvelles distributions, une rotation des positions et des stacks remis à zéro à chaque main. L’arène traite séparément les parties complètes avec stacks persistants.
Des résultats à lire avec leur contexte.
Le benchmark archivé seed42_transfer compare des agents entraînés à deux et quatre joueurs, ainsi que leur transfert entre ces formats. Son rapport de contrôle indique 24 modèles, 216 confrontations finales et 259 200 mains simulées, sans main tronquée. Ces effectifs décrivent l’ensemble du benchmark.
Extrait · PPO entraîné à 2 joueurs · curriculum puis self-play · table à 2 joueurs · stack de 50 BB · 1 200 mains par adversaire · seed d’entraînement 42.
| Adversaire | Gain BB/100 | Intervalle à 95 % |
|---|---|---|
| Aléatoire | +279,0 | [+123,9 → +434,1] |
| PPO figé | -48,9 | [-215,7 → +118,0] |
| DQN figé | +87,4 | [-117,0 → +291,8] |
| MCTS figé | -175,0 | [-302,4 → -47,7] |
Dans cet extrait, le gain estimé est positif contre l’agent aléatoire et négatif contre MCTS. Les intervalles correspondants restent de part et d’autre de zéro. Les intervalles face à PPO et DQN contiennent zéro : ces confrontations restent incertaines à cet effectif.
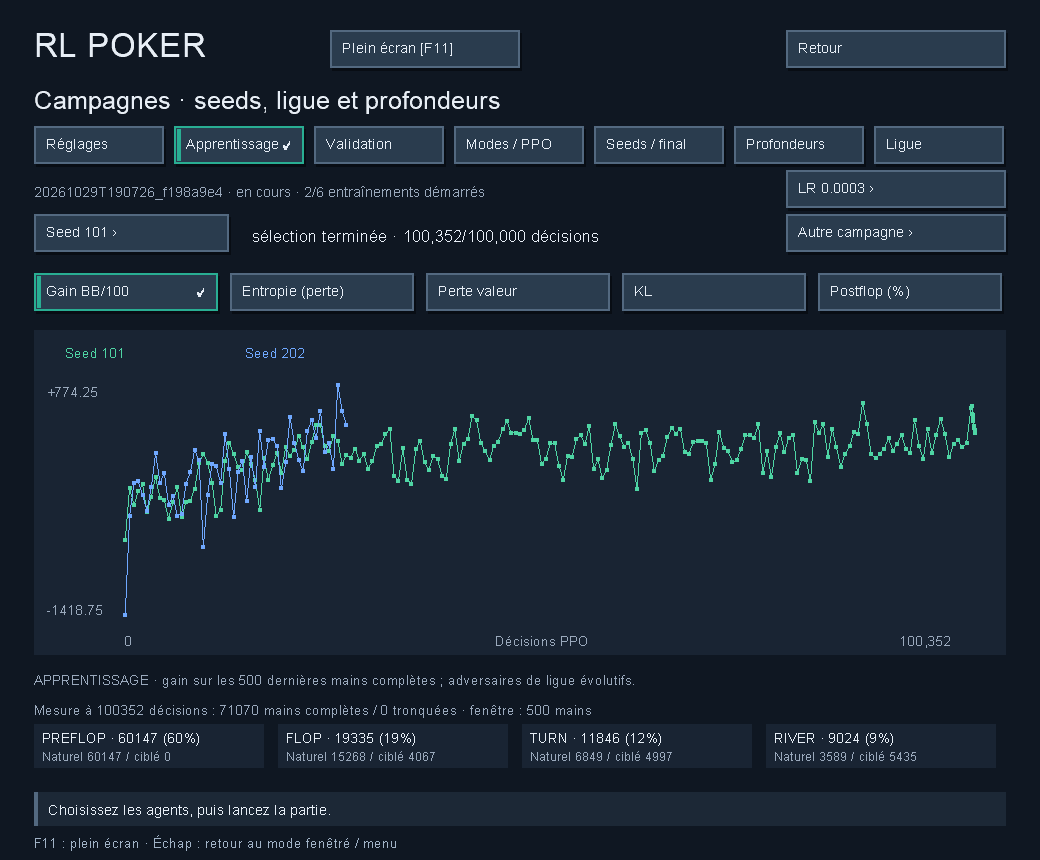
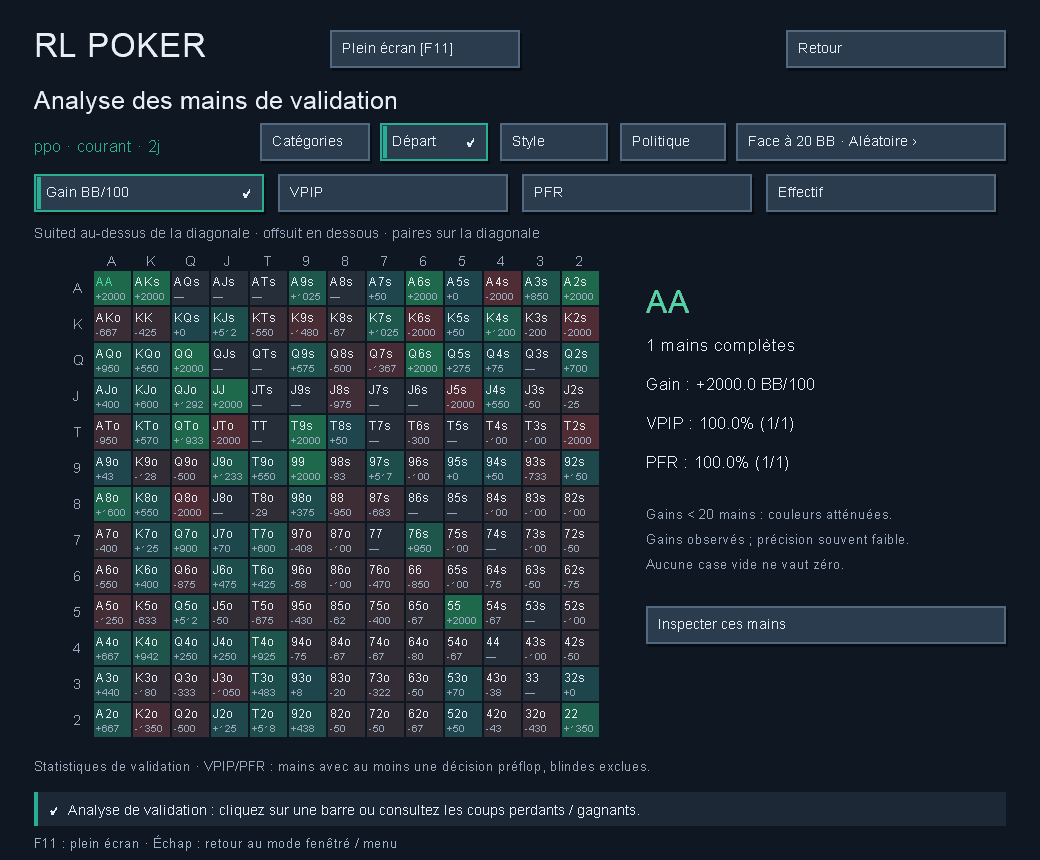
Les intervalles sont des approximations normales à 95 %, calculées séparément pour chaque confrontation. Cette expérience utilise une seule seed d’entraînement : elle ne mesure pas la variabilité entre initialisations, l’exploitabilité ou la force face à des joueurs humains. Les captures d’interface ci-dessous illustrent d’autres sessions. Leurs courbes ne sont pas celles de cet extrait.
Voir ce que l’agent apprend.
L’application Pyglet accompagne l’expérience : sélectionner les agents, observer une partie, suivre une campagne, conserver un checkpoint et inspecter les mains de validation. Les captures suivantes proviennent du projet local.
Suivre l’entraînement
Revenir aux décisions
Le comportement compte autant que le score.
Le projet rend visibles les liens entre représentation des cartes, choix des adversaires, protocole d’évaluation et stratégie obtenue. La suite consiste à comparer davantage d’initialisations, élargir les adversaires et analyser les faiblesses par situation plutôt que chercher un score unique.
Voir le dépôt GitHubPrésentation fondée sur le code et les archives locales. Le dépôt public peut différer de cette version de travail. Le moteur conserve la licence MIT d’origine de Neuron Poker, attribuée à Nicolas Dickreuter.